01המחשהLLM / INFERENCE
הרצת מודלים מקומית
הרצת LLM מקומי ו-RAG ארגוני לחיפוש במסמכים ולעוזרי ידע במשפטים ובפיננסים, עם הרשאות גישה מתאימות.
המודל, אורך ההקשר, משתמשים במקביל ויעדי זמן תגובה.
ACCESS TECHNOLOGIES / AI INFRASTRUCTURE
המודל שלכם. התשתית שמתאימה לו.
מריצים LLM מקומי, בונים RAG על מסמכי הארגון או מאמנים מודלים? נתאים שרת או תחנת עבודה ל-AI לפי המודל, נפח ה-VRAM והתקציב, כך שהמידע יישאר בשליטתכם ולא תשלמו על חומרה עודפת.
לא צריך להגיע עם מפרט. אפשר להתחיל מתיאור הצורך.
מעדיפים להתייעץ? כתבו לנו בוואטסאפ ↗המידע שלכם. החומרה שמתאימה לכם.
שרת AI מקומי או תחנת עבודה לבינה מלאכותית מאפשרים להריץ מודלי שפה (LLM) ולעבד מידע עסקי בתשתית בשליטתכם. מתאימים GPU וזיכרון לעומס בפועל, במקום לרכוש חומרה עודפת.
ב-2026, כשמחירי הזיכרון והאחסון משתנים, משווים לא רק מחיר רכישה אלא גם חשמל, תחזוקה והרחבה עתידית. באקסס מתרגמים את הדרישות למפרט ולהצעת מחיר ברורה: במה להשקיע עכשיו, ומה אפשר להוסיף בהמשך.
השלב הבא מתחיל בצורך שלכם
השאירו שם ודרך לחזור אליכם. נברר את השימוש ונכין הצעה עם מפרט, מחיר, אחריות וזמינות. אין צורך לדעת מראש איזה GPU לבחור.
גולדה מאיר 5, פארק המדע, נס ציונה
לעסקים, צוותי פיתוח, מחקר ואקדמיה
ארבע נקודות התחלה. התאמה אחת לצורך שלכם.
דוגמאות לשימושים ולסקטורים.
בחירה תעביר את הצורך לטופס הפנייה.
01המחשהLLM / INFERENCE
הרצת LLM מקומי ו-RAG ארגוני לחיפוש במסמכים ולעוזרי ידע במשפטים ובפיננסים, עם הרשאות גישה מתאימות.
המודל, אורך ההקשר, משתמשים במקביל ויעדי זמן תגובה.
02המחשהFINE-TUNING
התאמת מודלים למשימות של צוותי שירות ופיתוח, לפי נתוני הארגון, שיטת ההתאמה ורישיון המודל.
גודל המודל, שיטת ההתאמה, נפח הנתונים ותדירות העדכון.
03המחשהMACHINE LEARNING / DEEP LEARNING
למידת מכונה ו-Deep Learning לראייה ממוחשבת, לבקרת איכות וליישומי מוצר בתעשייה ובסטארטאפים.
סביבת הפיתוח, משך האימון, גודל האצווה והצורך בהתרחבות.
04המחשהHPC / DATA SCIENCE
מחשוב עתיר ביצועים (HPC), סימולציות וניתוח נתונים לביוטק, להנדסה ולאקדמיה, עם חומרה המותאמת לתוכנות שלכם.
התוכנה, סוג החישוב, הדיוק הנדרש וצווארי הבקבוק הקיימים.
ENGINEERED AROUND YOUR WORKLOAD


המחשה בשכבות תמונה, לא חתך טכני של דגם מסוים
WORKLOAD FIRST
איזה מודל או יישום תריצו, מי משתמש בו ומה נחשב אצלכם לתוצאה טובה? הדרישות מגדירות את המערכת, לא להפך.
GPU / VRAM
מתאימים זיכרון GPU, סוג מאיץ ואופן הרצה למודל וליעדי התגובה. מספר הכרטיסים לבדו אינו מספר את כל הסיפור.
MEMORY / STORAGE / NETWORK
RAM, אחסון NVMe ורשת צריכים להזין את המאיצים ולשמור את המידע בקצב שמתאים ליישום.
READY FOR YOUR ENVIRONMENT
בודקים גם חשמל, קירור, מקום פיזי, תאימות ואחריות. אפשרויות ההרחבה נבחנות כחלק מהתכנון.
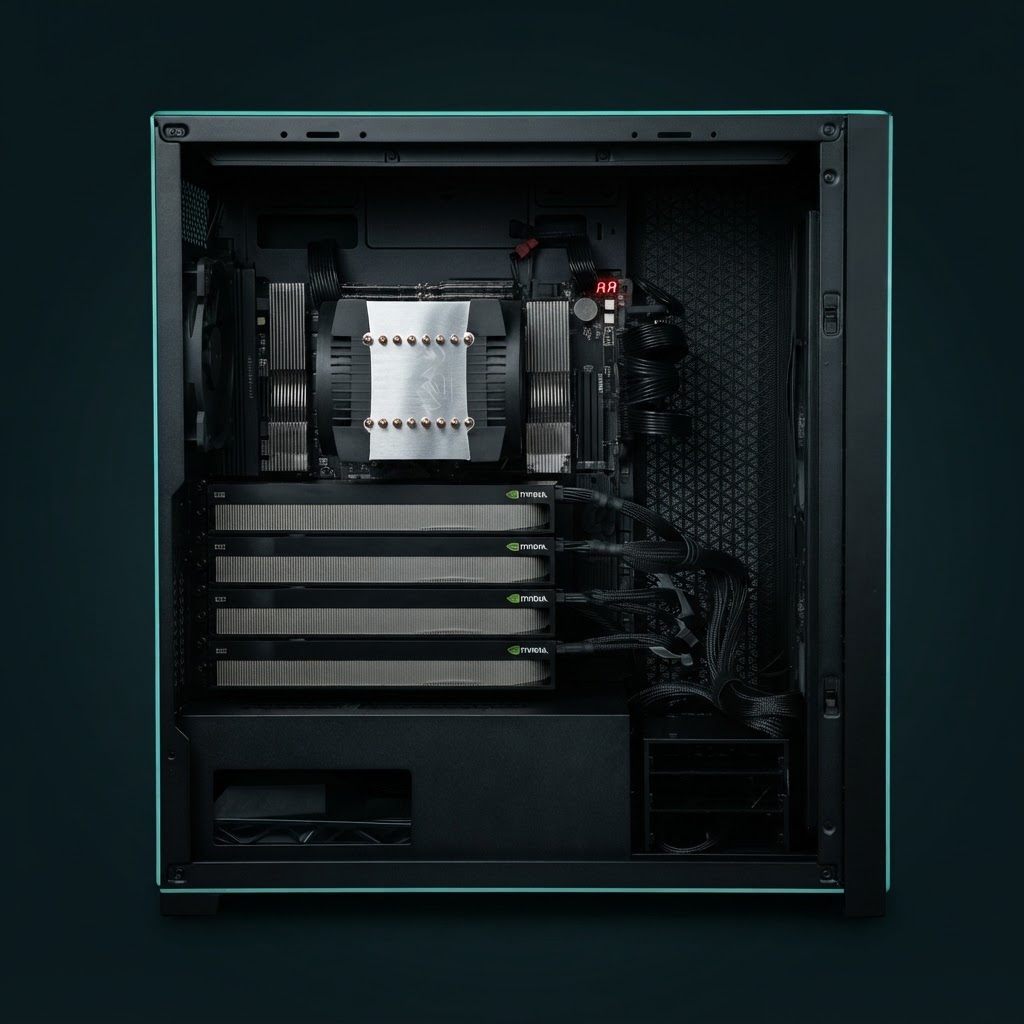
REAL BUILD / MULTI-GPU WORKSTATION
תחנת עבודה Multi-GPU לעומסי AI, שתוכננה סביב ארבעה כרטיסים, הספק, קירור ומקום להרחבה.
התצורה הנכונה, בסביבה הנכונה
שני כיוונים. לא שתי רמות איכות.
הבחירה תלויה בעומס ובסביבת ההתקנה.
המחשהAI WORKSTATION
מחשב לבינה מלאכותית למפתח, לחוקר או לצוות קטן. בוחרים GPU, זיכרון וקירור לפי המודל וסביבת העבודה, ובודקים גם רעש והרחבה עתידית.
המחשהAI RACK SERVER
תשתית המיועדת להשתלב בסביבת שרתים. מתכננים את החישוב יחד עם הניהול, הרשת ותנאי ההתקנה.
הבחירה נעשית לפי העומס, הרעש, הקירור וההרחבה, לא לפי צורת המארז בלבד.
אקסס טכנולוגיות / התהליך
המודל, הנתונים, סביבת ההתקנה והתקציב.
שיקולי החומרה והאיזון בין רכיבי המערכת.
מפרט, תכולה, חריגים, אחריות וזמינות שנבדקה.
בהתאם לתכולה ולתנאים המפורטים בהצעה.
כל הצעה נשענת על הדרישות שלכם, עם תכולת אספקה, אחריות, זמן אספקה שנבדק ואפשרויות הרחבה רלוונטיות.
לדעת לפני שבוחרים
לא חייבים לדעת מראש איזה GPU לבחור.
נתחיל מהצורך שלכם.
מחיר שרת GPU או שרת AI תלוי במאיצים, ב-VRAM, בזיכרון RAM, באחסון ובאחריות. אפשר להתחיל מטווח תקציב ותיאור השימוש, בלי מפרט מוכן. ההצעה תפרט רכיבים, מחיר, תכולת אספקה, אחריות וזמינות שנבדקה.
לא בהכרח הכרטיס היקר ביותר. מתחילים מהמודל, נפח ה-VRAM, אורך ההקשר ומספר המשתמשים, ומתאימים RAM, אחסון NVMe וחשמל. בתקופה של לחץ מחירים בזיכרון ובאחסון, כדאי להשוות עלות כוללת ואפשרויות הרחבה, במקום לקנות חומרה עודפת.
Inference הוא שימוש במודל שכבר אומן כדי להפיק תוצאות. Fine-tuning מתאים מודל קיים למשימה או לנתונים נוספים. Training הוא תהליך אימון, לעיתים מההתחלה. לכל מסלול דרישות חישוב, זיכרון וזמן שונות.
בוחרים GPU, למשל כרטיס NVIDIA תואם, לפי המודל, הכימות (quantization), אורך ההקשר, גודל האצווה ומספר המשתמשים. אין נפח שמתאים לכולם. במערכת Multi-GPU הזיכרון אינו מתחבר אוטומטית; נדרשת תמיכה במנוע ההרצה ובחלוקת המודל.
RAG מוסיף למודל שפה מידע ממסמכי הארגון בזמן ההרצה, למשל לצורך חיפוש ועוזר ידע, ואינו אימון המודל. לא תמיד נדרש שרת גדול: מתאימים את החומרה למודל, להיקף המסמכים, למספר המשתמשים ולזמן התגובה הנדרש.
בפריסה מקומית אפשר לעבד מסמכים ומידע עסקי בלי לשלוח אותם לשירות AI חיצוני, כאשר כל רכיבי המערכת מוגדרים לכך. כך מקבלים יותר שליטה במיקום הנתונים ובהרשאות; עדיין נדרשים אבטחה, עדכונים וגיבוי, ובדיקת חיבורים וטלמטריה.
מודלי gpt-oss-20b ו-gpt-oss-120b של OpenAI זמינים להרצה מקומית, למשל באמצעות Ollama או vLLM. הם אינם שירות ChatGPT או המודלים הסגורים שלו. אפשר לבנות סביבם צ׳אט מקומי, עם חומרה מתאימה ובכפוף לרישיון ולתנאי השימוש.
בוחנים עומס קבוע לעומת משתנה, תפעול ותחזוקה, שליטה בנתונים, גמישות ועלות כוללת לאורך זמן. מערכת מקומית אינה תמיד זולה יותר. הדף הזה מיועד לרכישת חומרה, לא להשכרת GPU או לאירוח בענן.
האחריות, השירות ותכולת האספקה יפורטו בהצעה בהתאם לדגם ולרכיבים. הרחבה כפופה לחשמל, לקירור, למקום פיזי, לחריצים ולתאימות. זמינות וזמן אספקה נבדקים עבור ההצעה הספציפית.
תיאור השימוש, תוכנה או מודל, דרישות ידועות, כמות מערכות ומועד מתוכנן. אם יש מפרט קיים אפשר להדביק אותו בטופס ולתאם העברת מסמך בהמשך. גם אם לא כל הפרטים ידועים, אפשר להתחיל מהצורך העסקי.
חלונית עוגיות נפתחה אוטומטית. לסגירה יש ללחוץ על כפתור הסגירה או על אחד מכפתורי הבחירה
אנו משתמשים בעוגיות כדי לשפר את חווית הגלישה שלך, לנתח תנועה באתר ולהתאים תוכן ופרסומות. בהמשך השימוש באתר, את/ה מסכים/ה למדיניות העוגיות שלנו. מידע נוסף